¿Alguna vez necesitaste obtener datos de un sitio web sin API? Quizá quieras monitorear los precios de tus competidores, recopilar prospectos de un directorio empresarial o extraer artículos para analizarlos. Copiar y pegar esta información manualmente es lento, tedioso y propenso a errores. Aquí entra el web scraping con n8n. Con n8n puedes crear flujos de trabajo automatizados para extraer exactamente los datos que necesitas de cualquier sitio web y ahorrar muchas horas de trabajo manual.
Esta guía te enseñará a hacer web scraping con n8n, desde los conceptos básicos hasta técnicas más complejas. Verás desde la extracción sencilla de HTML con n8n en páginas estáticas hasta el procesamiento de sitios dinámicos que dependen de JavaScript. Al terminar, podrás convertir cualquier sitio web en una fuente de datos estructurados y crear un pipeline completo de extracción de datos con n8n.
Conceptos básicos del web scraping con n8n: nodos principales
Todo proceso de web scraping con n8n sigue dos pasos sencillos:
- Obtener: Envías una solicitud al servidor de un sitio web, como lo haría un navegador, y recibes el código HTML sin procesar de la página.
- Analizar: Revisas ese código HTML para encontrar y extraer los datos específicos que te interesan, como el nombre o precio de un producto o el título de un artículo.
n8n incluye dos nodos que se encargan de este proceso. Conviene entender la función de cada uno.
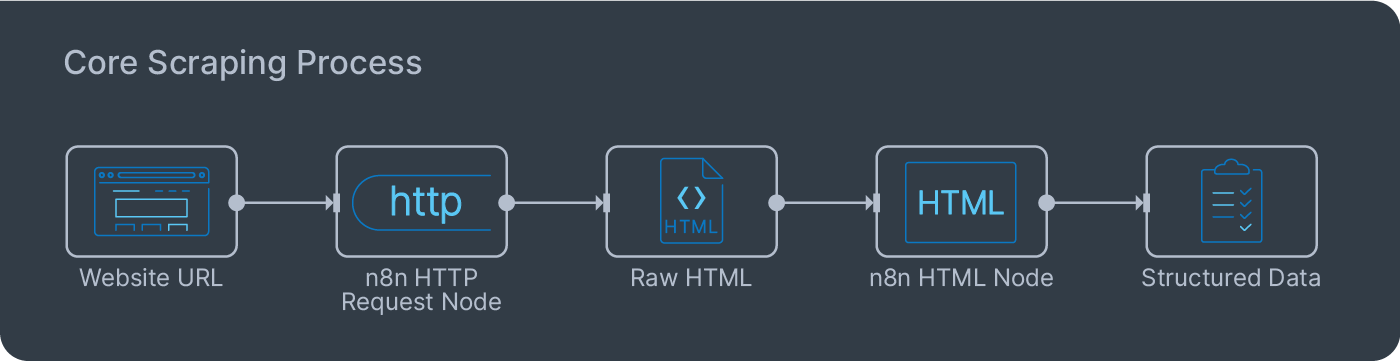
El primero es el nodo HTTP Request de n8n. Esta herramienta obtiene la página web. Le proporcionas una URL y devuelve todo el código fuente HTML de esa página. No renderiza la página ni ejecuta JavaScript. Solo obtiene el código sin procesar, justo lo que necesitas para el tipo de scraping más común y rápido.
El segundo es el nodo HTML, que se encarga del análisis. Recibe el HTML sin procesar del paso anterior y te permite usar selectores CSS, los mismos que se emplean para dar estilo a las páginas, para localizar y extraer datos específicos. Al separar la obtención del análisis, puedes crear y depurar tus flujos de trabajo con mayor facilidad.
Scraping sencillo: cómo extraer contenido HTML con el nodo HTTP Request
Veamos un ejemplo práctico de web scraping con n8n. El objetivo será realizar una tarea sencilla: extraer los títulos de las publicaciones más recientes de un blog.
Paso 1: Obtén la página con el nodo HTTP Request
Primero, agrega un nodo HTTP Request de n8n a tu flujo de trabajo.
- En el campo URL, ingresa la URL completa de la página que quieres extraer.
- Deja Method como
GET. - Ejecuta el nodo. Si recibes un error 403 Forbidden, consulta la solución más adelante.
Paso 2: Analiza los títulos con el nodo HTML
Cuando tengas el HTML, conecta un nodo HTML a la salida del nodo HTTP Request. Aquí realizarás la extracción de HTML con n8n.
- Configura Operation como «Extract HTML Content».
- En la tabla Extraction Values, indica al nodo qué debe buscar.
- En Key, escribe
title. Es solo una etiqueta para los datos que vas a extraer. - En CSS Selector, ingresa el selector específico del elemento que quieres obtener. Para encontrarlo, haz clic derecho sobre el elemento en tu navegador y elige «Inspeccionar». En el panel de desarrollador, haz clic derecho sobre el elemento HTML resaltado y selecciona Copy > Copy selector. El selector CSS se copiará al portapapeles y podrás pegarlo directamente en el nodo HTML de n8n.
- En Return Value, selecciona «Text».
- En Key, escribe
- Ejecuta el nodo. La salida será una lista limpia con el contenido de texto extraído.
Cómo solucionar un error 403 Forbidden
Si recibes de inmediato un error 403 Forbidden en el paso 1, es una situación común. El servidor del sitio identificó que la solicitud proviene de un script automatizado y la bloqueó. La causa más frecuente es que falte un User-Agent.
Un User-Agent es una cadena que indica al servidor qué tipo de navegador envía la solicitud. De forma predeterminada, el nodo HTTP Request de n8n envía uno técnico que resulta fácil de detectar.
Cómo corregirlo, primer paso: Haz que la solicitud parezca provenir de un navegador web real.
- En el nodo HTTP Request, busca la sección Headers.
- Haz clic en Add Header.
- En el campo Name, escribe
User-Agent. - En el campo Value, pega una cadena User-Agent de un navegador común. Puedes usar esta opción estándar:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36 - Ejecuta el nodo de nuevo. En la mayoría de los casos, este encabezado corrige el error 403 y permite obtener el HTML de la página.
Si el cambio del User-Agent no funciona, otra causa frecuente del bloqueo es la dirección IP de tu servidor. Puedes agregar la opción Proxy al nodo HTTP Request para usar un servidor proxy. Así, la solicitud pasa por otra dirección IP y puede evadir bloqueos sencillos basados en IP.
¿Qué puedes hacer si aún no funciona? Siguiente paso:
Si el error 403 continúa, es probable que el sitio use un servicio de detección de bots más complejo, como Cloudflare. Estos servicios bloquean solicitudes provenientes de direcciones IP conocidas de centros de datos, incluidos los servidores cloud de n8n. El User-Agent es correcto, pero el origen de la solicitud está marcado.
En este caso, aplica las técnicas de «Scraping avanzado» que aparecen más adelante. Necesitarás un proxy residencial o una API especializada en scraping que dirija la solicitud por un navegador real con una dirección IP residencial. Así se parecerá a la solicitud de un usuario normal.
Limpieza y formato de los datos extraídos
Los datos extraídos no siempre quedan limpios. Pueden incluir espacios adicionales o caracteres no deseados, o quizá necesites convertirlos a otro formato. Puedes resolverlo directamente en n8n mediante expresiones. Por ejemplo, para quitar espacios al inicio y al final de un título, usa {{ $json.title.trim() }}.
Para transformaciones más complejas, usa el nodo Code. Este nodo te permite escribir un pequeño fragmento de JavaScript para procesar los datos. Puedes quitar símbolos de moneda de un precio, cambiar el formato de una fecha o separar un nombre completo en nombre y apellido. Esta limpieza mantiene uniformes los datos que guardarás y los deja listos para analizarlos.
Scraping avanzado con n8n: páginas dinámicas con Ultimate Scraper
El método sencillo con HTTP Request es rápido, pero tiene límites en los sitios modernos. Si un sitio depende de JavaScript para cargar contenido o está protegido por servicios como Cloudflare, probablemente recibirás un error o una página vacía. En estos casos necesitas otro método para el scraping avanzado con n8n.
n8n no incluye un nodo nativo de Selenium que controle directamente un navegador. Sin embargo, la comunidad creó nodos que se integran con servicios dedicados de scraping. Estos servicios ejecutan navegadores reales, rotan proxies y resuelven CAPTCHA. Tú solo agregas un nodo sencillo al flujo de trabajo. Suele ser el método más práctico para tareas de scraping difíciles.
La opción recomendada: un nodo comunitario dedicado al scraping
Para la mayoría de los usuarios, la forma más efectiva de extraer datos de un sitio dinámico o protegido es usar un nodo comunitario integrado con un servicio como ScrapeNinja o Firecrawl. Son API especializadas en scraping y están diseñadas para superar medidas antibots.
Estos son los pasos para trabajar con un nodo como ScrapeNinja:
- Instala el nodo comunitario: En tu instancia de n8n, ve a Settings > Community Nodes e instala el nodo del servicio elegido, por ejemplo,
n8n-nodes-scrapeninja. - Agrega el nodo a tu flujo de trabajo: Tras instalarlo, encontrarás un nuevo nodo ScrapeNinja en el panel de nodos. Agrégalo a tu flujo de trabajo.
- Configura el scraping:
- Extrae los datos: Estos servicios suelen incluir analizadores. Puedes proporcionar selectores CSS dentro del nodo para obtener los datos necesarios o enviar todo el HTML renderizado a un nodo HTML estándar de n8n.
Para extraer datos de sitios difíciles con n8n, se recomienda usar un nodo comunitario dedicado porque reduce mucho la complejidad. El servicio administra la automatización del navegador, la rotación de proxies y las medidas antibots. Así puedes concentrarte en los datos. También resulta más confiable y fácil de mantener que una integración propia con un navegador headless.
De datos a información útil: análisis con IA después del scraping
Extraer datos es apenas el primer paso. Su valor depende de lo que hagas con ellos. Después de extraer HTML con n8n, normalmente obtienes texto sin estructura. La IA puede procesarlo y ampliar las funciones de tu flujo de trabajo.
Conecta un nodo de IA como OpenAI o Google Gemini después del nodo HTML para limpiar, estructurar y analizar de inmediato el contenido extraído. Supón que recopilaste reseñas de clientes sobre un producto. El texto original tiene formatos y estilos distintos. Puedes enviar cada reseña a un nodo de IA con una instrucción como esta:
«Del siguiente texto de una reseña, extrae el sentimiento (positivo, negativo o neutral), identifica las características mencionadas y asigna una calificación del 1 al 5. Responde en formato JSON.»
La IA devolverá un objeto JSON limpio y estructurado similar a este:
{
  "sentiment": "Positive",
  "features_mentioned": ["battery life", "screen quality"],
  "rating": 5
}
Después puedes insertar estos datos estructurados directamente en una base de datos o una hoja de cálculo mediante nodos como Postgres o Google Sheets. El flujo de scraping se convierte en un pipeline de datos con n8n que transforma automáticamente contenido web desordenado en información estructurada y lista para analizar.
Flujo práctico: automatización de prospectos con n8n
Combina estos conceptos para crear un flujo práctico de generación de prospectos con n8n. El objetivo es encontrar clientes potenciales en un directorio web y agregarlos a una lista. Así automatizas una tarea que tomaría horas si se hiciera manualmente.
- Extrae el directorio: Comienza con un directorio de empresas locales, como una lista de agencias de marketing de una ciudad. Usa los nodos HTTP Request o un servicio externo de scraping y HTML para extraer el nombre y la URL del sitio web de cada empresa.
- Encuentra un correo de contacto: Para cada sitio web extraído, usa un servicio como Hunter.io para encontrar una dirección de correo publicada. n8n incluye un nodo Hunter específico para esta tarea.
- Filtra y enriquece: Agrega un nodo IF para descartar las empresas sin correo. Para los prospectos válidos, puedes usar un nodo OpenAI que visite su sitio mediante la técnica del paso 1 y redacte una introducción personalizada para un correo de contacto basada en la página «Acerca de nosotros».
- Agrega los datos a la lista de prospectos: Usa el nodo Google Sheets o Airtable para agregar el nombre de la empresa, el sitio web y el correo de contacto a tu lista principal.
Este flujo automatiza toda la parte inicial del embudo. Tu equipo de ventas ahorra horas de búsqueda manual y puede concentrarse en establecer relaciones con los prospectos.
Cómo escalar flujos de web scraping con n8n
Cuando tu proyecto de web scraping con n8n pasa de unas cuantas páginas a cientos o miles, debes adaptar el diseño del flujo. Un flujo lineal alcanza pronto sus límites de rendimiento o termina bloqueado. Para escalar n8n, crea flujos modulares, resistentes a errores y respetuosos con los servidores de los que extraes datos.
Control de concurrencia para evitar sobrecargas
Un error común es obtener una lista de 1,000 URL y enviarla de inmediato a un nodo HTTP Request. De forma predeterminada, n8n intentará ejecutar las 1,000 solicitudes en paralelo. Esto puede provocar una falla en tu instancia de n8n y casi con certeza hará que bloqueen tu dirección IP.
La forma correcta es controlar la concurrencia.
- Usa el nodo Loop Over Items: Inserta un nodo Loop Over Items antes del nodo HTTP Request. Configura un lote pequeño, como 5 o 10 elementos. Así, n8n solo procesará unas cuantas URL al mismo tiempo.
- Agrega un nodo Wait: Después de procesar cada lote, agrega un nodo Wait para pausar el flujo durante algunos segundos. Esta limitación ayuda a evitar topes de solicitudes y genera un patrón parecido al de un usuario normal.
División de flujos grandes mediante subflujos
Un único flujo enorme que obtiene URL, extrae páginas, limpia datos y los guarda en una base resulta difícil de depurar y mantener. Para tareas complejas de scraping, crea subflujos más pequeños y modulares.
- Flujo principal: Un flujo «maestro» coordina todo el proceso. Su única tarea es obtener la lista de URL y enviar cada una a un subflujo.
- Subflujo de scraping: El flujo «maestro» lo activa mediante un nodo Execute Sub-Workflow. Recibe una sola URL, extrae la página, limpia los datos y devuelve el resultado estructurado.
Este diseño modular simplifica la solución de problemas en n8n. Si falla una parte específica del proceso, solo tendrás que depurar ese flujo pequeño y específico.
Manejo de errores
En cualquier tarea de scraping a gran escala habrá fallas. Un sitio web puede dejar de responder, cambiar su diseño o perder la conexión con el proxy. Tu flujo debe manejar estas situaciones sin detenerse por completo.
- Usa Continue on Fail: En cada nodo que pueda fallar, como HTTP Request o HTML, abre la pestaña Settings y selecciona «Continue (using error output)» en la opción «On Error».
- Crea una ruta de error: El nodo mostrará una segunda salida de «error». Conéctala a una rama separada del flujo que registre la falla. Por ejemplo, puedes conectarla a un nodo Google Sheets configurado para agregar una fila a una hoja llamada «Registro de errores». Guarda la URL que falló y el mensaje específico para revisar y procesar de nuevo esos elementos más adelante.
Estas prácticas te permiten crear flujos de web scraping con n8n estables, rápidos y fáciles de administrar a medida que aumentan tus necesidades de datos.
Preguntas frecuentes sobre web scraping con n8n
¿Es legal el web scraping?
Es un área legal con varios matices. Para evitar problemas, revisa siempre el archivo robots.txt del sitio, no sobrecargues el servidor con demasiadas solicitudes y evita extraer datos personales o contenido protegido por derechos de autor. Si tienes dudas, actúa con cautela.
¿Cómo proceso sitios que requieren iniciar sesión?
En los sitios que requieren iniciar sesión, debes administrar una sesión. Primero inicia sesión desde tu navegador y abre las herramientas de desarrollador. Busca la cookie de sesión, normalmente en la pestaña «Network» o «Application». Copia su valor y agrégalo como encabezado Cookie en la configuración del nodo HTTP Request. Así, tus solicitudes parecerán provenir de la sesión abierta en el navegador.
¿Qué ocurre si cambia el diseño del sitio web?
Es el mayor reto y una realidad inevitable del web scraping. Si un sitio rediseña sus páginas, es probable que los selectores CSS dejen de funcionar y el flujo falle. Debes volver al nodo HTML y actualizar los selectores para adaptarlos al nuevo diseño. Los scrapers requieren mantenimiento ocasional para seguir funcionando.